AIの学習を断るためのrobots.txtの共通の書き方が、2026年10月30日にIETFへ提出されました。自社のページを勝手にAIの学習に使われるのはいやだけれど、AIに近くのお店や会社を聞かれたときには名前を出してほしい。正直、どっちも本音ですよね。
今回の書き方が断る(拒否する)のは学習だけで、AIの回答の材料や検索に載るかどうかは別に決められます。だからこそ書き方を間違えると、止めたくなかったものまで止めてしまうことがあります。集客のためのサイトなら、慌てて書き足す前に何を断りたいのかを決めておくのがおすすめです。
この記事でわかること
- robots.txtの新しい書き方 __usage_ai-training とは何か
- Google・Bing・OpenAIはいつから対応するのか
- 自社のサイトに書くかどうかの決め方
- 検索から消えないための書き方の注意
今すぐ書かなくても大丈夫。学習と回答の材料は分けて考える
robots.txtの新しい書き方(__usage_ai-training)が扱うのは、AIのモデルを作ったり改善したりする「学習」です。Google検索やBing検索の結果に載るかどうかは変わらず、AIがその場で回答を作るときにページを読む「回答の材料」とも別の話になります。
| 気になること | 答え(2026年11月3日時点) |
|---|---|
| もう書けば効く? | まだ提案の段階。Bingは2027年2月1日から、Googleは2027年の初めに対応すると発表している |
| 書くと検索に出なくなる? | 出なくなるわけではない。Bingは検索結果への掲載は変わらないと説明している |
| AIの回答にも出なくなる? | 学習の設定と回答の材料の設定は別。回答の材料はサービスごとに別の設定がある |
| 小さな会社のサイトはどうする? | 集客に使うサイトなら、今は様子見でいいと思う。断るなら学習だけか、回答の材料までかを先に決める |
__usage_ai-trainingとは?会社名ではなく「使い道」で断る書き方
robots.txt(ロボッツテキスト)とは、サイトの一番上の階層に置いて、検索エンジンなどの自動で巡回するプログラムにどこを読んでいいかを伝えるテキストファイルのことです。これまでAIの学習を断りたいときは、OpenAIならGPTBot、GoogleならGoogle-Extendedというように、会社ごとの名前を1つずつ書く必要がありました。
2026年10月30日に、IETF(インターネットの技術の標準を話し合う団体)に「Machine-Readable Training Preference Signal」という文書が提出されました。会社ごとの名前の代わりに、使い道を表す共通の名前「__usage_ai-training」を書くという提案です。
User-Agent: __usage_ai-training
Disallow: /
これでサイト全体をAIの学習に使わないでほしい、という意思表示になるんですね。Disallowのところに /blog/ のようにフォルダーを書けば、その場所だけを断ることもできます。ここでいう学習は「生成AIのモデルを作り変えるためにコンテンツを使うこと」と定義されていて、文章の分類や並べ替えだけをするAIは含まれないとされています。
ひとつ注意したいのは、この文書がIETFの正式な標準ではなく、個人として出された提案だという点です。同じ作業部会では「Content-Usage: train-ai=n」という別の書き方の文書も話し合われているので、細かい書き方はこれから変わるかもしれません。
Google・Bing・OpenAIはいつから対応する?
Google・Bing・OpenAIの対応は、発表の内容とはっきりしている度合いがかなり違います。次の表では公式ページで確かめられたことと報道で分かることを分けました。
| 会社 | 新しい書き方への対応 | 根拠 |
|---|---|---|
| Microsoft(Bing) | 2027年2月1日から、巡回したときに読み取って反映する | 公式ブログ(2026年10月30日) |
| 2027年の初めに対応する予定 | 公式のクローラーの説明(2026年10月30日更新) | |
| OpenAI | 今後数か月のうちに対応すると報じられている | 報道(公式の発表ページはこちらから本文を読めず未確認) |
Bingは日程をいちばん細かく出していて、2026年12月15日にBing Webmaster Tools(Bingのサイト管理ツール)で回答の材料についての一時的な設定を受け付け、2027年3月1日からは古い設定(NoArchive・NoCache)を学習と回答の材料の指定としては読まなくなるそうです。Googleの場合、新しい書き方をGoogle-Extendedの設定としても扱うと報じられていますが、こちらから読めた公式の説明には「2027年の初めに対応する予定」とだけ書かれていました。対応が始まるタイミングで、公式の説明をもう一度見ておくと安心です。
学習・回答の材料・検索、3つの使われ方を分ける
今回いちばん大事なのは、サイトのコンテンツの使われ方が3つに分かれていることだと思います。検索結果に載ること、AIがその場で回答を作るときに材料として読むこと、AIのモデルの学習に使われることの3つです。新しい書き方が届くのは、このうちの学習だけなんですね。
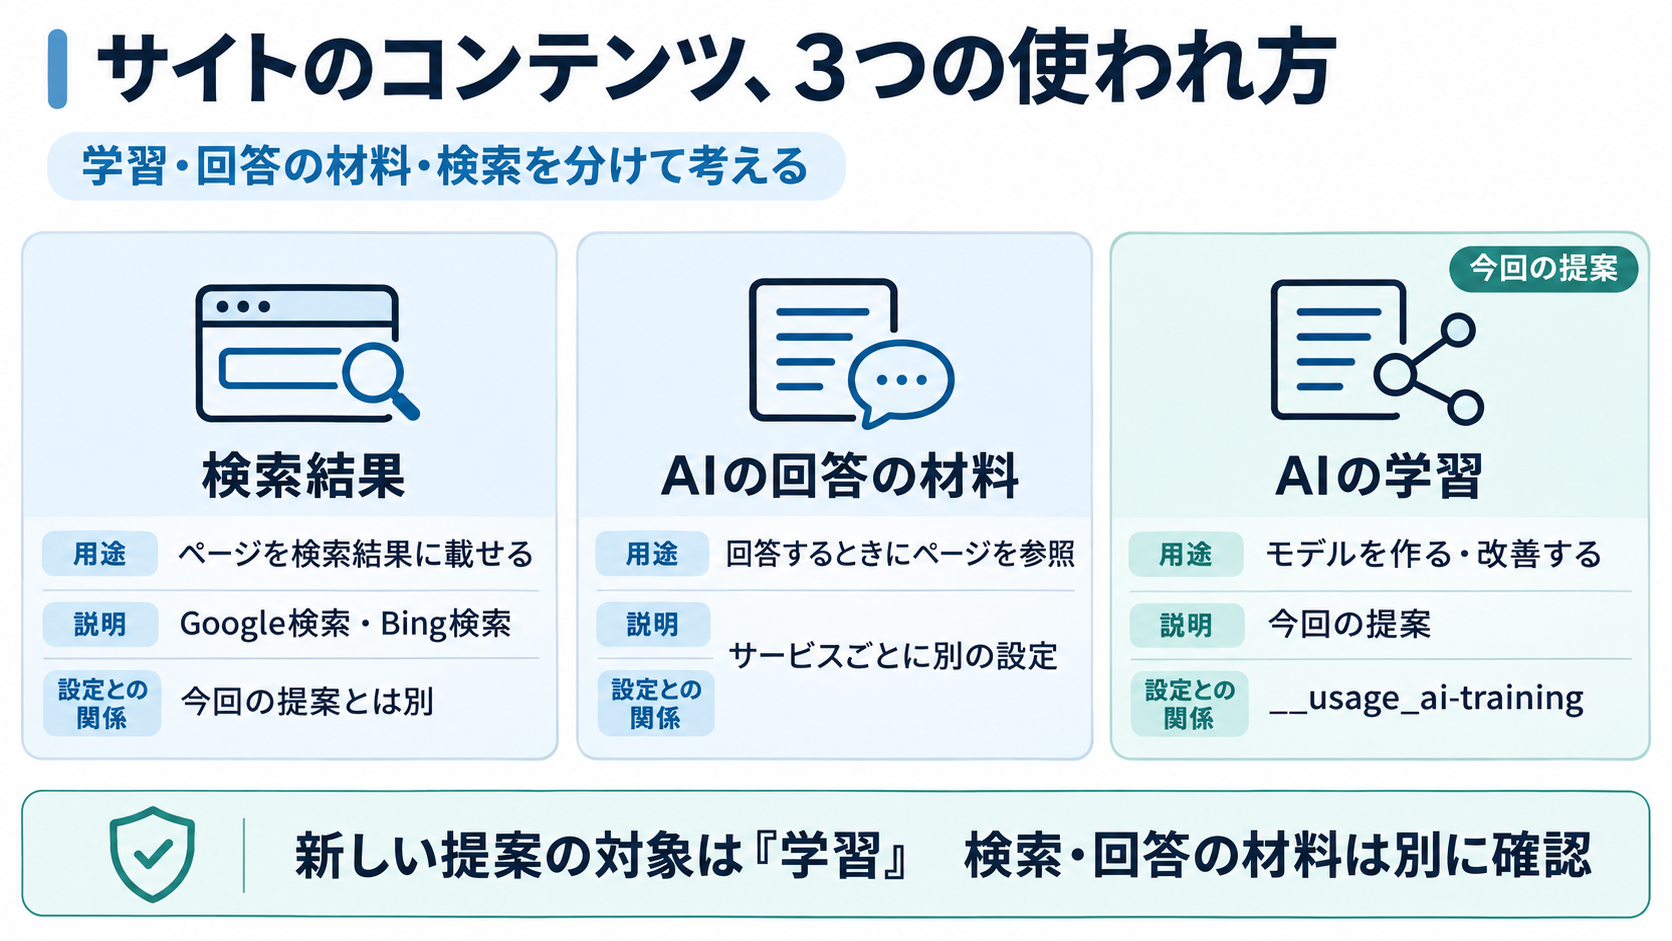
それぞれを断る方法は2026年11月3日時点の公式の説明だと次のとおりです。
| 使われ方 | 例 | 断る方法 |
|---|---|---|
| 検索結果に載る | Google検索、Bing検索 | 今回の書き方では変わらない。載せたくないページはnoindexなど |
| AIの回答の材料 | Bing・CopilotのAIの回答、Geminiアプリ、ChatGPTの検索 | Bingはページごとのmetaタグかヘッダー、GeminiアプリはGoogle-Extended、ChatGPTの検索はOAI-SearchBot |
| AIの学習 | 生成AIのモデルを作る・改善する | 新しい __usage_ai-training。今はGPTBot、Google-Extendedなど会社ごとの名前 |
気をつけたいのは、同じAI向けの設定でも名前によって届く範囲が違うことです。たとえばGoogle-ExtendedはGeminiの学習だけでなく、Geminiアプリなどで回答を作るときの材料にも効きます。一方でGoogle検索のAIの機能(AIによる概要など)については、検索での表示を制限するnosnippetなどの設定が案内されていて、Google-Extendedは「Googleのほかのシステム」向けの設定とされています。OpenAIもGPTBot(学習)とOAI-SearchBot(ChatGPTの検索)の設定はそれぞれ独立していると説明しています。
Bingの回答の材料(グラウンディング)の設定はrobots.txtでサイト全体には書けず、ページごとのmetaタグかHTTPヘッダーで指定する形です。断る範囲は「すべて断る」と「Microsoftが自社で提供するサービスだけに限る」から選べます。
決め手はAIの回答で紹介されたいかどうか
書くかどうかは、AIに使われたくないかより、AIの回答で紹介されたいかで決めるのがおすすめです。会社やお店のサイトは問い合わせや来店につなげるためにあることがほとんどだと思います。そういうサイトがAIの回答の材料まで断ると、AIに「近くで頼める会社は?」と聞かれたときに名前が出る機会を自分で減らすことになります。
一方で学習だけを断っても、公式の説明どおりならGoogle検索・Bing検索への掲載や、各社の回答の材料の設定には影響しません。なので選び方はざっくり言うと次の3つになります。
- 何もしない:集客のためのサイトで、学習に使われても特に困らない場合。今のままでも困ることはあまりありません。
- 学習だけ断る:AIの回答では紹介されたいけれど、文章や写真をモデルづくりに使われるのは気が進まない場合。
- 学習も回答の材料も断る:有料の記事、会員向けの資料、独自に集めたデータなど、AIの回答で中身を代わりに答えられると困る場合。
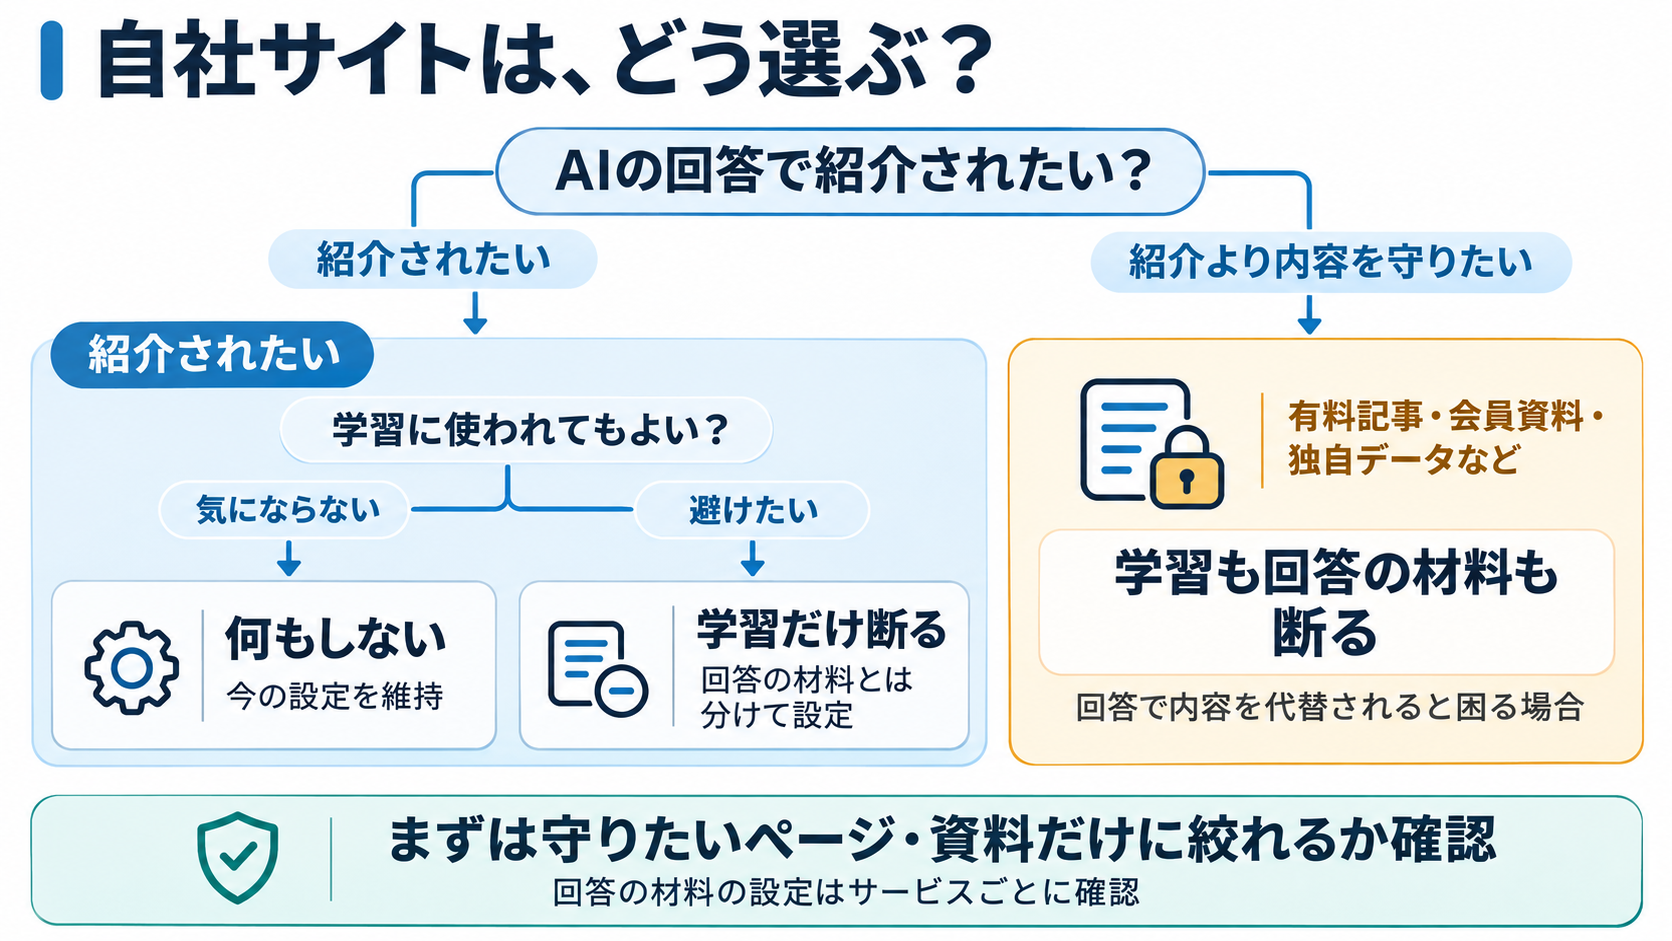
3つ目を選ぶ場合も、サイト全体ではなくその資料を置いた場所だけに絞れるかを先に考えてみてください。会社の紹介やサービスのページまで断ってしまうと、本当に守りたいもの以外の露出まで減ってしまいます。
robots.txtの書き方:ほかの行と混ぜずに独立させる
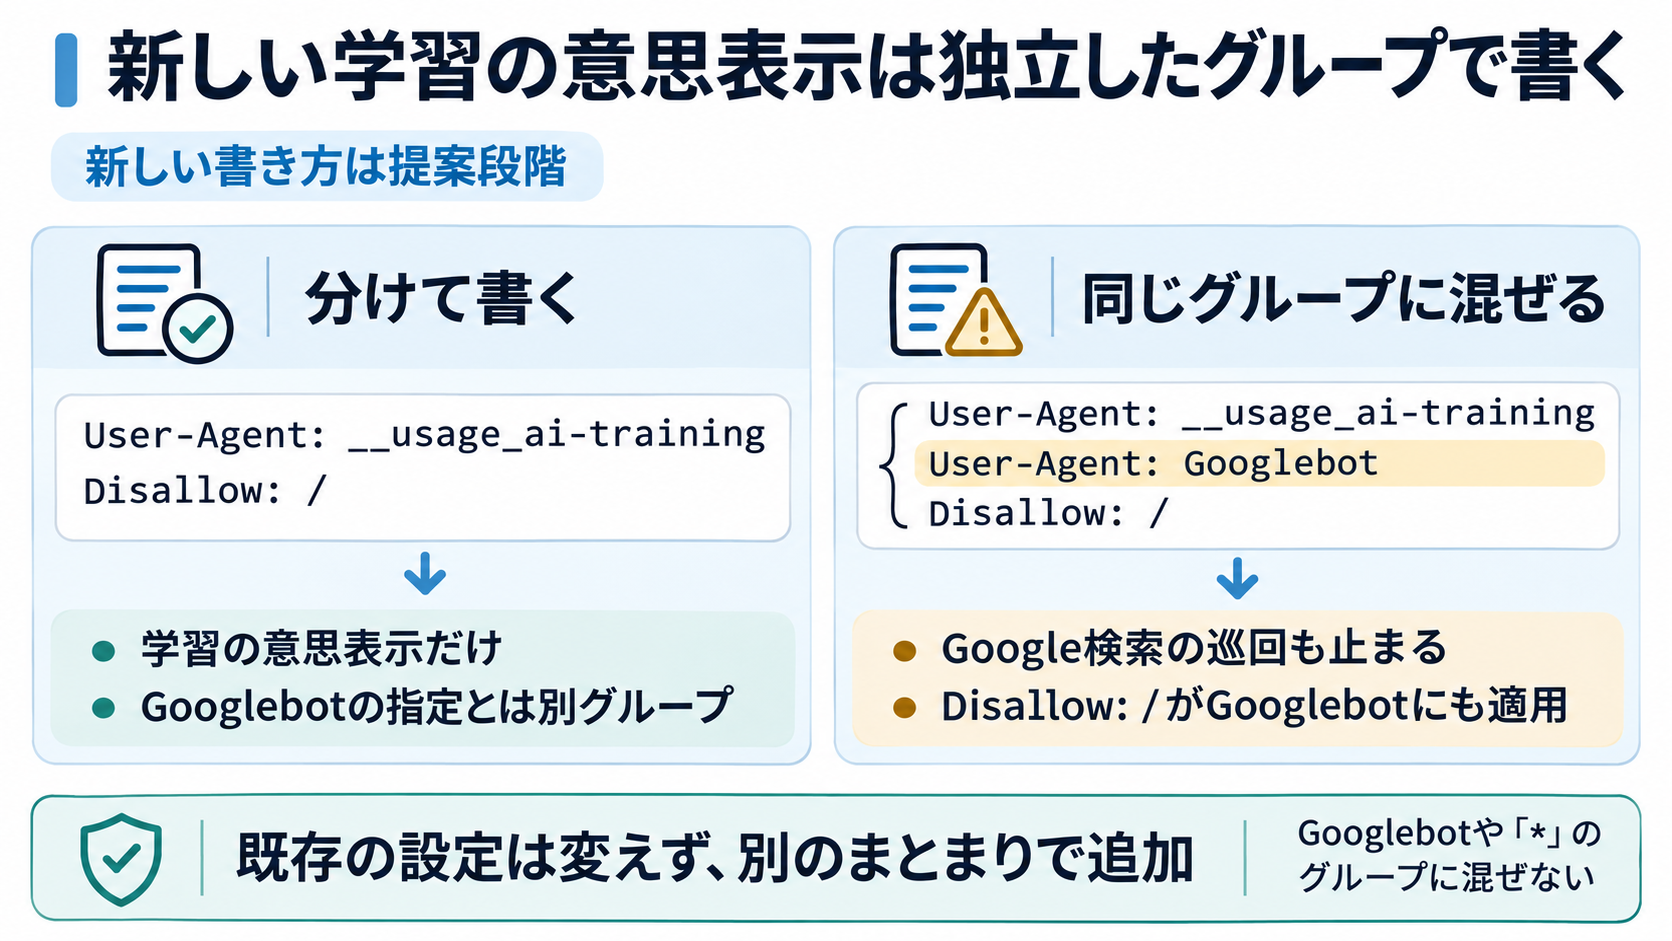
robots.txtに書くと決めたら、新しい名前は「User-Agent: __usage_ai-training」だけのまとまり(グループ)として書くのがポイントです。robots.txtは「User-Agent」の行から始まるまとまりごとにルールを読むので、ほかの名前と同じまとまりに入れると思わぬ効き方をします。
# 正しい例:学習の意思表示だけのまとまりにする
User-Agent: __usage_ai-training
Disallow: /

# 避けたい例:Googlebotと同じまとまりに入れる
User-Agent: __usage_ai-training
User-Agent: Googlebot
Disallow: /
2つ目の書き方だと「Disallow: /」がGooglebotにも効くので、Google検索のための巡回まで止めることになります。学習を断るつもりで検索から消えてしまうのは、いちばん避けたい失敗ですよね。もう1つ、「User-Agent: 」(すべての巡回プログラム)のまとまりは、この新しい名前には当てはまらないと提案の文書に書かれています。今ある「」の行に足すのではなく、別のまとまりとして書く必要があります。
WordPressのサイトの場合、WordPressにはrobots.txtのファイルを置いていなくても標準の内容を表示する機能があります。SEOプラグインのrobots.txtの編集画面で書き換えている場合もあるので、まずはどこで管理しているかを確かめてから触るのがおすすめです。
書く前と書いたあとに確かめる順番
いきなり書き足すより、今の状態を見てからのほうが失敗しません。次の順番で確かめてみてください。
- 今のrobots.txtを見る:ブラウザで「自社のドメイン/robots.txt」を開き、今の内容をテキストファイルに保存しておく。戻したくなったときに、この控えがあれば元に戻せます。
- 会社ごとの名前の行を見る:GPTBot、Google-Extended、OAI-SearchBotなどの行がすでにあるかを見る。提案の文書でも巡回プログラムごとの設定とは別のものとされているので、今ある行はそのまま残す。
- どこで管理しているかを確かめる:サーバーに置いたファイルか、WordPressやSEOプラグインの設定かを確かめる。
- 書いたあとに開き直す:もう一度ブラウザでrobots.txtを開き、新しいまとまりが独立していて、Googlebotや「*」の行が変わっていないかを見る。
Googleはrobots.txtの内容を通常は最大24時間キャッシュするとしているので、反映には少し時間がかかります。Bingも設定は巡回したときに読み取るので、書いた瞬間に効くわけではないそうです。ここまで見られたら、書き足しの作業は完了です!
断るつもりで、やりすぎていませんか?
ニュースを見て慌てて設定すると、次のようなやりすぎにつながることがあります。
- robots.txtで「User-Agent: *」に「Disallow: /」を書いて、すべての巡回を止める
- 検索やAIの回答に使われる巡回プログラム(BingbotやOAI-SearchBotなど)をまとめてブロックする
- 会社ごとの名前(GPTBot、Google-Extended)の行を消して、新しい書き方に置き換える
- 各社の対応が始まる前に、効き目を確かめないまま設定を増やす
とくに気をつけたいのは、学習を断るつもりで検索やAIの回答への露出まで止めてしまうことです。Bingも、どちらの設定にしてもAIの回答に載ることやアクセスが増えることを保証するものではないと説明しています。書いたかどうかより、何を断ったのかを自分で説明できる状態にしておくほうが大事だと思います。
小さな会社のサイトはどうする?
robots.txtなんて、サイトを作ってもらってから一度も開いていないという会社もあるかもしれません。集客のためのサイトなら、今回は「何もしない」を選んで、各社の対応が始まる2027年に入ってから考えるのでも遅くないと思います。まずは今のrobots.txtを開いて、控えを取っておくだけでも次の判断がラクになります。
断りたいコンテンツがある場合は、サイト全体ではなく、その資料を置いた場所だけを断れるかを先に考えてみてください。AI検索で見つけてもらうためのサイトの整え方まで含めて相談したい場合は、今の設定と直す順番の整理からホームページ改善診断へお気軽にご相談ください。
まとめ
2026年10月30日に提出された __usage_ai-training は、AIの学習を断るためのrobots.txtの共通の書き方です。Bingは2027年2月1日から、Googleは2027年の初めに対応する予定で、検索結果への掲載やAIの回答の材料の設定とは別のものです。まずは自社のrobots.txtを開いて、今どんな行があるかを見てみてください。
とはいえ、各社の対応が始まるのは2027年に入ってから。正直なところ細かい書き方もまだ変わるかもしれないので、今は何を断りたいのかを考えておくくらいでちょうどいいと思います。